


.svg)

.svg)


.svg)
.svg)


.svg)

.svg)


النفق الذي يقطعك عن شبكتك أسوأ من ألّا يكون عندك نفق. لأنك أغلقت المنافذ العامة اعتماداً عليه، فإن سقط سقطت معه كل طرقك إلى كل برج.
هذا الجزء عن شيئين: أن تشخّص العطل في دقيقة بدل ساعة، وأن تبني منفذ إنقاذ يفتحه الراوتر بنفسه حين ينقطع النفق ويغلقه بنفسه حين يعود — جرّبناه فعلاً وسنريك السجلّ.
كل ما في هذه السلسلة مُنفَّذ فعلاً. بنينا المختبر على سيرفر Proxmox VE: خادم WireGuard على حاوية، وراوتر MikroTik RouterOS 7 على جهاز افتراضي يمثّل برجاً، وشبكة أجهزة سكتر خلفه. كل مخرج أمر في هذه المقالات مأخوذ من ذلك المختبر حرفياً — وقد استبدلنا العناوين العامة الحقيقية بعناوين التوثيق المخصّصة لهذا الغرض (RFC 5737) حفاظاً على أمان السيرفر.
أولاً: ثلاثة أوامر تحسم السبب
لا تبدأ بإعادة تشغيل أي شيء. ابدأ بهذه — بهذا الترتيب:
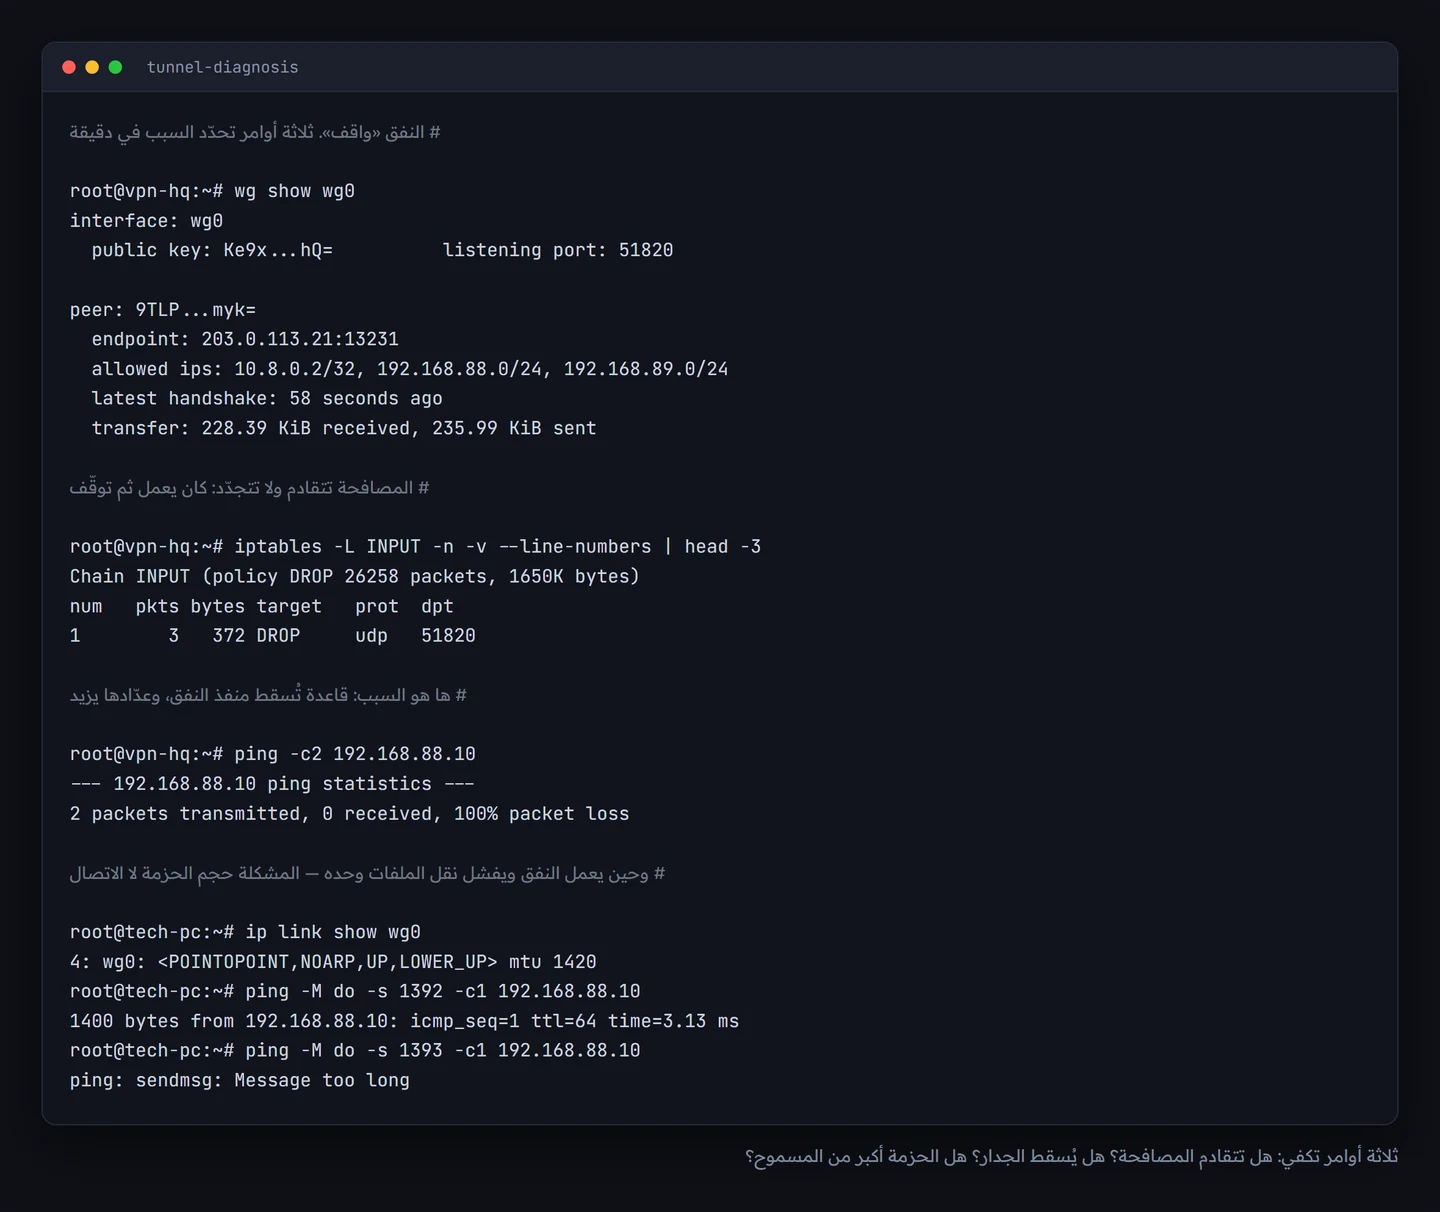
1) wg show — اقرأ سطر المصافحة قبل أي شيء
| ما تراه | ما يعنيه | إلى أين تذهب |
|---|---|---|
| لا latest handshake إطلاقاً | الطرفان لم يتصلا قط | مفاتيح · عنوان · منفذ |
| مصافحة تتقادم ولا تتجدّد | كان يعمل ثم توقّف | جدار ناري · مسار · keepalive |
| مصافحة حديثة وping يفشل | النفق حيّ والتوجيه خاطئ | AllowedIPs والمسارات |
| مصافحة حديثة وكل شيء يعمل إلّا الملفات | حجم الحزمة | MTU |
| endpoint يتغيّر باستمرار | عنوان البرج متغيّر | طبيعي — لا شيء تفعله |
2) عدّادات الجدار — من يُسقط الحزم؟
iptables -L INPUT -n -v --line-numbers | headفي مختبرنا ظهر السبب في السطر الأول مباشرة: قاعدة DROP على UDP 51820 وعدّادها يزيد. وهذه هي الفائدة الحقيقية من العدّادات: تفرّق بين «لا أحد يحاول» و«أحدهم يحاول وأنا أمنعه» — وهما عطلان مختلفان تماماً وحلّاهما متعاكسان.
3) اختبار الحجم — أخبث عطل في هذا الباب
ping -M do -s 1392 -c1 192.168.88.10    # مرّت
ping -M do -s 1393 -c1 192.168.88.10    # ping: sendmsg: Message too long
مع MTU يساوي 1420، أكبر حمولة تمرّ هي 1392 بايت (1420 ناقص 20 لترويسة الشبكة و8 لترويسة الاختبار). هذا الحدّ بالضبط هو ما رأيناه في المختبر.
عطل الـMTU لا يبدو عطل شبكة. الـping يعمل، والدخول إلى الراوتر يعمل، والصفحة الأولى تفتح — ثم يتوقّف تحميل ملف أو تحديث نسخة في منتصفه ولا يكمل. ومن لا يعرف هذا العَرَض يقضي ساعات في المكان الخطأ. علاجه: mtu=1420 على واجهة النفق، و1400 إن كان البرج خلف PPPoE.
جدول تشخيص سريع
| العَرَض | السبب الأرجح | الفحص |
|---|---|---|
| النفق لا يقوم منذ البداية | مفتاح منسوخ ناقصاً | قارن wg show بالمفتاح عند الطرف الآخر |
| يعمل ثم ينقطع كل بضع دقائق | keepalive ناقص خلف NAT | persistent-keepalive=25s |
| ينقطع بعد إعادة تشغيل الخادم | الخدمة غير مفعّلة عند الإقلاع | systemctl enable wg-quick@wg0 |
| برج واحد فقط لا يعمل | مزوّد البرج يحجب UDP | جرّب منفذاً آخر مثل 443/UDP |
| كل الأبراج سقطت معاً | الخادم أو عنوانه | ابدأ من الخادم لا من الأبراج |
| يعمل من هاتفك ولا يعمل من المكتب | جدار المكتب يحجب UDP الصادر | اختبر من اتصال آخر |
| المصافحة تحدث والـping يفشل | AllowedIPs | ip route get <العنوان> |
| القواعد اختفت بعد إعادة التشغيل | لم تُحفظ | netfilter-persistent save |
ثانياً: منفذ الإنقاذ — الراوتر ينقذ نفسه
الآن الجزء الأهم. الفكرة بسيطة: يراقب الراوتر النفق بنفسه، فإن سقط فتح منفذ إدارة واحداً مقيّداً بعنوان مكتبك، وإن عاد أغلقه. لا تدخّل منك، ولا منفذ يبقى مفتوحاً منسياً.
الخطوة 1: قاعدة إنقاذ معطّلة مسبقاً
/ip/firewall/filter/add chain=input action=accept \
    protocol=tcp dst-port=8291 in-interface=ether1 \
    src-address=203.0.113.5 \
    comment="RESCUE winbox from office" disabled=yes \
    place-before=0
مقيّدة بعنوان مكتبك الثابت، ومعطّلة افتراضياً. ولا تجعلها مفتوحة للجميع — منفذ إنقاذ مفتوح للعالم هو بالضبط ما بنينا هذه السلسلة لتجنّبه.
الخطوة 2: سكربتان
/system/script/add name=rescue-on \
    policy=read,write,policy,test dont-require-permissions=yes \
    source="/ip/firewall/filter/enable [find comment~\"RESCUE\"];
            :log warning \"tunnel down - rescue port opened\";"

/system/script/add name=rescue-off \
    policy=read,write,policy,test dont-require-permissions=yes \
    source="/ip/firewall/filter/disable [find comment~\"RESCUE\"];
            :log info \"tunnel restored - rescue port closed\";"
الخطوة 3: مراقب يشغّلهما
/tool/netwatch/add host=10.8.0.1 interval=20s timeout=2s \
    down-script=rescue-on up-script=rescue-off \
    comment="HQ tunnel health"
الفخّ الذي أوقفنا ساعة: السكربت المكتوب بلا policy ينجح حين تشغّله بيدك، ويفشل حين يشغّله netwatch برسالة «could not run script: not enough permissions». وإضافة policy وحدها لا تكفي — يحتاج أيضاً dont-require-permissions=yes. بلا هذين لن يعمل الإنقاذ، ولن تكتشف ذلك إلّا يوم تحتاجه. تحقّق دائماً من /log print بعد أول تجربة.
الخطوة 4: جرّبه الآن لا يوم العطل
اقطع النفق قصداً وراقب. هذا ما حدث في مختبرنا بالضبط:
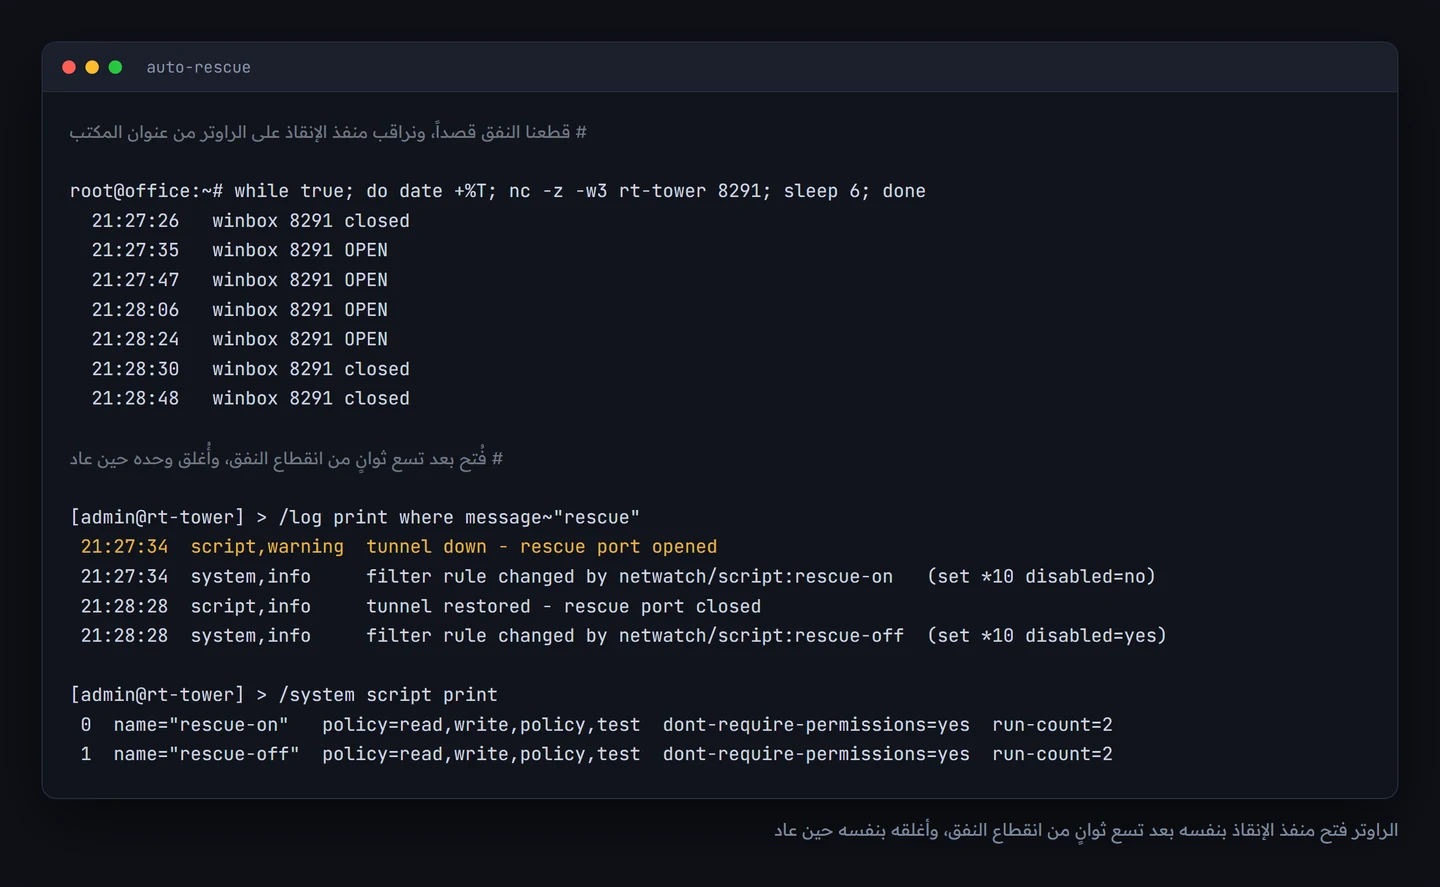
لاحظ run-count في آخر المخرجات: هذا هو الدليل على أن السكربت عمل فعلاً. وإن بقي صفراً بعد انقطاع حقيقي فإعدادك لا يعمل.
منافذ إنقاذ أخرى — رتّبها من الأقوى إلى الأضعف
| الوسيلة | متى تنفع | ملاحظة |
|---|---|---|
| منفذ مؤقّت بقاعدة تلقائية | عطل في النفق أو إعداد خاطئ | الأفضل — مقيّد وذاتي الإغلاق |
| MAC Winbox من داخل نفس المقسم | ضاع عنوان الراوتر | يحتاج وجودك على الشبكة المحلية |
| مودم LTE احتياطي في البرج | سقوط الوصلة الرئيسية | يُغطّي ما لا تغطّيه البرمجيات |
/system reset-configuration مجدول | إعداد قاتل عن بُعد | ألغِ الجدولة بعد نجاح التغيير |
| نسخة إعداد قبل كل تعديل | دائماً | /export file=before-change |
الحيلة التي تنقذك من الإعداد القاتل
قبل أي تعديل خطر على راوتر بعيد — قاعدة جدار، تغيير عنوان، تعديل توجيه — اجدول عودةً تلقائية:
/system/scheduler/add name=undo start-time=startup interval=10m \
    on-event="/system/reset-configuration no-defaults=no skip-backup=no"
ثم نفّذ تعديلك. إن نجح، احذف الجدولة فوراً. وإن قطعك التعديل عن الراوتر، سيعيد نفسه بعد عشر دقائق ويعود متاحاً. عشر دقائق انتظار أرخص من ثلاث ساعات طريق.
راقب النفق قبل أن يتصل بك أحد
أبسط مراقبة نافعة: netwatch على كل راوتر يرسل تنبيهاً حين يسقط النفق:
/tool/netwatch/add host=10.8.0.1 interval=30s \
    down-script=":log error \"HQ tunnel DOWN\"; /tool/e-mail/send [email protected] subject=\"tunnel down\" body=[/system/identity/get name];"
وعلى الخادم، فحص دوري بسيط يكفي تماماً:
#!/bin/bash
# /usr/local/bin/wg-check
for p in $(wg show wg0 peers); do
  last=$(wg show wg0 latest-handshakes | grep "$p" | awk '{print $2}')
  age=$(( $(date +%s) - last ))
  [ "$last" -eq 0 -o "$age" -gt 300 ] && echo "peer $p stale (${age}s)"
done
ضعه في cron كل خمس دقائق. مصافحة أقدم من خمس دقائق تعني نفقاً ميتاً، وستعرف ذلك قبل أن يتصل بك أحد من البرج.
أسئلة شائعة
كم يجب أن يبقى منفذ الإنقاذ مفتوحاً؟
حتى يعود النفق فقط — وهو ما يفعله الإعداد أعلاه تلقائياً. لا تتركه لتقديرك البشري؛ ستنساه.
ألا يُضعف منفذ الإنقاذ كل ما بنيناه؟
لا، ما دام مقيّداً بعنوان واحد ويُغلق نفسه. المقارنة ليست بينه وبين الإغلاق التام، بل بينه وبين نزولك إلى البرج — أو بينه وبين منفذ تتركه مفتوحاً دائماً «احتياطاً».
وإن لم يكن لمكتبي عنوان ثابت؟
قيّده بنطاق مزوّدك، أو استعمل نفقاً احتياطياً على منفذ آخر بدل منفذ إدارة مباشر.
ما أكثر سبب لسقوط النفق عملياً؟
بترتيب ما نراه: تعديل جدار ناري، ثم keepalive ناقص، ثم إعادة تشغيل بلا تفعيل الخدمة، ثم انقطاع فعلي عند المزوّد. والثلاثة الأولى كلها أخطاء إعداد — أي أنها قابلة للمنع كلياً.
هل أحتاج نظام مراقبة كاملاً؟
لا للبداية. سكربت من خمسة أسطر وnetwatch يغطّيان 90٪ مما ستحتاجه. وحين تكبر شبكتك ستعرف بنفسك ما ينقصك.
خلاصة السلسلة
بنينا في سبعة أجزاء شبكة إدارة كاملة لمزوّد إنترنت: خادم نفق بمنفذ واحد، وكل برج يخرج إليه بنفسه، وكل جهاز خلف كل راوتر متاح بعنوانه المحلي، وشبكة المشتركين معزولة تماماً، ولكل فنّي نطاقه، ومنفذ إنقاذ يفتحه الراوتر بنفسه ويغلقه بنفسه.
والمقابل: سيرفر واحد بعنوان ثابت يعمل على مدار الساعة. هذا كل ما تحتاجه البنية كلها — وأصغر باقة تكفيه. اطّلع على باقات VPS من مرام هوست.
هذه المقالة من سلسلة «أدر شبكتك من مكتبك» — بناء شبكة إدارة عن بُعد لمزوّدي الإنترنت ومكاتب الشبكات: ١. لماذا VPN أصلاً · ٢. خادم WireGuard · ٣. اربط راوتر البرج · ٤. أجهزة السكتر خلف الراوتر · ٥. اعزل شبكة المشتركين · ٦. صلاحية لكل فنّي · ٧. حين ينقطع النفق


