
موقعك لا يفتح، وتكتشف بعد ساعات أن Nginx أو قاعدة البيانات أو حاوية Docker توقفت؟ إتقان إعادة تشغيل الخدمات ومراقبتها هو ما يفصل بين تعطّل يدوم دقائق وآخر يدوم ساعات. في هذا الدليل الشامل نتعلم إعادة تشغيل الخدمات ومراقبتها معًا: كيف تعرف لماذا توقفت الخدمة وتعيد تشغيلها — بل وتجعلها تعود وحدها — وكيف تعرف بالتوقف فورًا عبر مراقبة مجانية بـUptime Kuma مع تنبيهات تيليجرام. «أوقعنا» Nginx عمدًا على سيرفر حقيقي في مرام هوست، ثم أوقفنا موقعًا تجريبيًا وراقبنا كيف اكتشف Uptime Kuma التوقف خلال 14 ثانية.
⚡ الإجابة المختصرة
الحالة والسبب: systemctl status nginx ثم sudo journalctl -u nginx -n 50. التشغيل: sudo systemctl restart nginx. العودة التلقائية: sudo systemctl edit nginx وأضف Restart=on-failure. المراقبة: Uptime Kuma في Docker مع تنبيه تيليجرام من @BotFather.
محتويات الدليل
لماذا تهمّ إعادة تشغيل الخدمات ومراقبتها؟
الخدمات تتوقف لأسباب واقعية: نفاد الذاكرة، خطأ إعداد، امتلاء القرص، أو تحديث. المشكلة ليست التوقف نفسه، بل كم تبقى لا تعرف أنه حدث. لذلك تُعدّ إعادة تشغيل الخدمات ومراقبتها مهارتين متلازمتين لكل من يدير سيرفرًا:
- تقليل زمن التعطّل: اكتشاف فوري + عودة تلقائية = دقائق بدل ساعات من التوقف.
- معرفة السبب لا العَرَض: السجل (journalctl) يخبرك لماذا توقفت حتى لا تتكرر المشكلة.
- راحة البال: تنبيه تيليجرام يصلك قبل أن يخبرك العميل أن الموقع لا يعمل.
- حماية السمعة والمبيعات: كل دقيقة توقف لمتجر أو خدمة تعني خسارة مباشرة.
هذا الدليل يجمع طرفَي المعادلة: إعادة تشغيل الخدمات ومراقبتها معًا، بأدوات مجانية ومجرّبة على سيرفر حقيقي. وأساس إدارة الخدمات موثّق في مشروع systemd الرسمي.
الجزء 1: هل الخدمة تعمل؟
كل برنامج يعمل في الخلفية على سيرفر لينكس (Nginx وMySQL وDocker وSSH) هو «خدمة» يديرها systemd. أول أمر دائمًا:

الأسماء الشائعة: nginx، apache2، mysql أو mariadb، php8.3-fpm، docker، ssh.
الجزء 2: لماذا توقفت؟ اسأل السجل
لتجربة حقيقية «قتلنا» عملية Nginx الرئيسية بـkill -9 (كما يحدث عند نفاد الذاكرة). هكذا بدت الحالة وماذا قال السجل:

sudo journalctl -u nginx -n 50 --no-pager       # آخر 50 سطرًا
sudo journalctl -u mysql --since "1 hour ago"    # آخر ساعة
sudo tail -50 /var/log/nginx/error.log           # سجل أخطاء Nginx نفسه
sudo journalctl -k | grep -i "killed process"    # هل قتل النظام شيئًا لنقص الذاكرة؟
الجزء 3: اجعل الخدمة تعود وحدها
أغلب الخدمات لا تعيد تشغيل نفسها افتراضيًا. أضف لها «ملف تعديل» (override) بأمر sudo systemctl edit nginx، والصق السطرين، واحفظ. جرّبناه: قتلنا Nginx مرة ثانية فعاد وحده بعد 5 ثوانٍ:

حاويات Docker: شغّلها دائمًا مع --restart unless-stopped (أو restart: unless-stopped في docker-compose) فتعود بعد أي توقف أو إعادة تشغيل للسيرفر. لمعرفة سبب توقف حاوية: sudo docker ps -a ثم sudo docker logs --tail 50 اسم-الحاوية.
الجزء 4: اعرف بالتوقف فورًا — Uptime Kuma وتيليجرام
Uptime Kuma أداة مراقبة مجانية مفتوحة المصدر: تفحص موقعك كل بضع ثوانٍ وترسل تنبيهًا إلى تيليجرام (أو البريد أو واتساب عبر خدمات وسيطة) عند التوقف والعودة. نصّبناها بـDocker على نفس السيرفر، بحيث تعمل على المنفذ الداخلي 3001 فقط، وأمامها Nginx بشهادة SSL:
sudo docker run -d --name uptime-kuma --restart unless-stopped \
  -p 127.0.0.1:3001:3001 -v uptime-kuma:/app/data louislam/uptime-kuma:1
ثم أضف موقعًا في Nginx يمرر إلى 127.0.0.1:3001 وأصدر له شهادة — الإعداد جاهز في قسم «Nginx أمام تطبيق» من دليل Nginx وSSL. عند أول فتح تنشئ حساب المدير، ثم Add New Monitor:

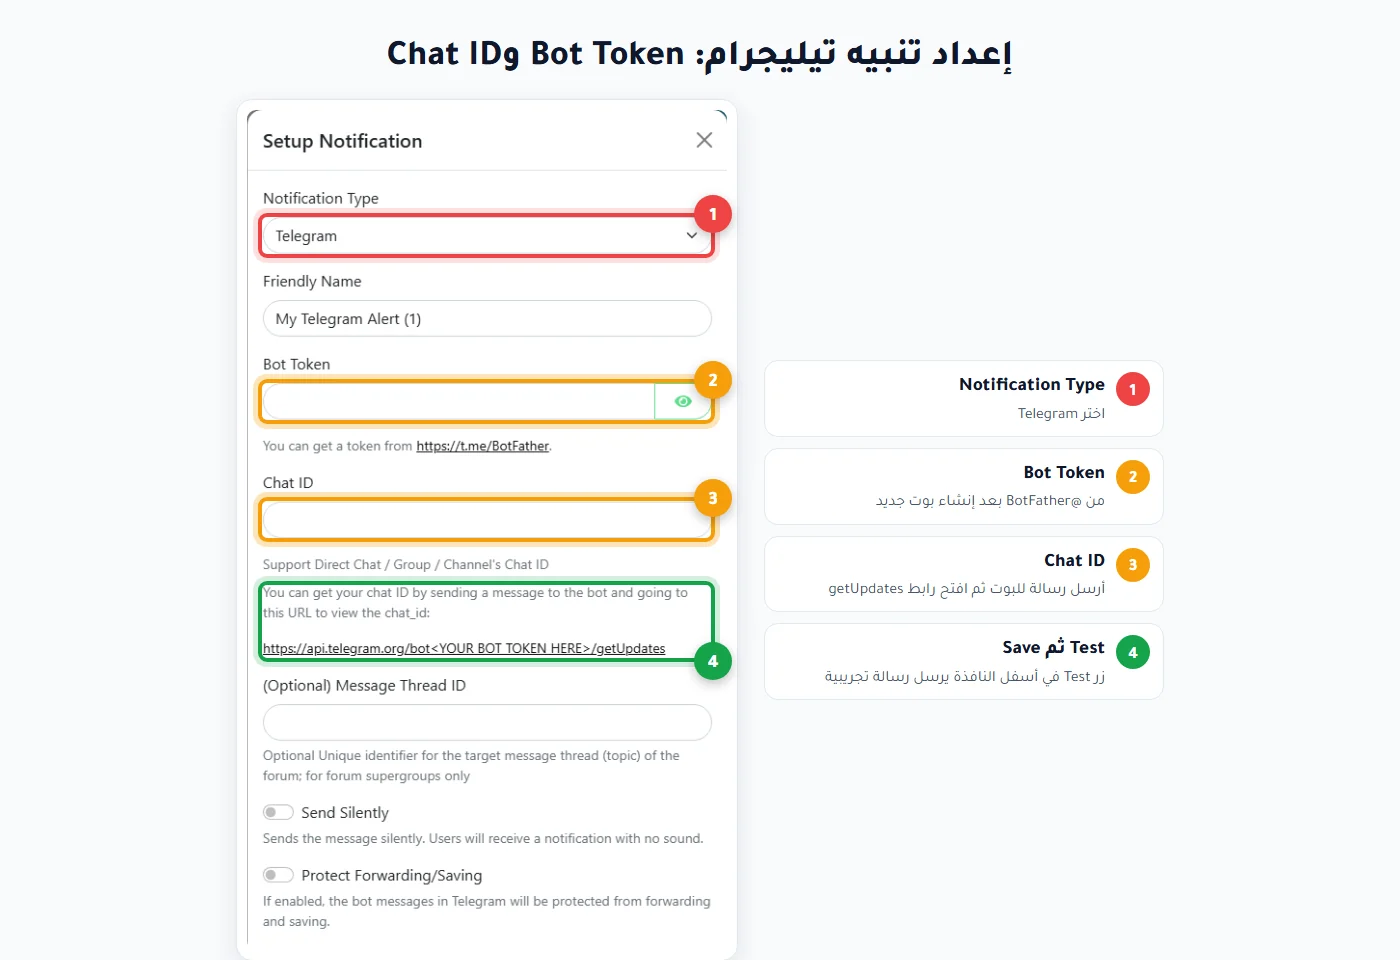
تنبيه تيليجرام: في تيليجرام افتح @BotFather وأرسل /newbot، واختر اسمًا، فيعطيك Bot Token. أرسل أي رسالة لبوتك الجديد، ثم افتح في المتصفح https://api.telegram.org/bot<TOKEN>/getUpdates وانسخ رقم chat.id. ضع القيمتين في Uptime Kuma واضغط Test:
التجربة: جعلنا الموقع التجريبي يرد بخطأ 503، فظهر التوقف في لوحة Uptime Kuma خلال 14 ثانية مع سبب واضح — وهي الرسالة نفسها التي تصلك على تيليجرام:

وعندما أعدنا الموقع، تحولت الحالة إلى Up وبقي أثر التوقف في السجل ونسبة التوفر:

نصائح إعادة تشغيل الخدمات ومراقبتها
- راقب من خارج السيرفر أيضًا: Uptime Kuma على نفس السيرفر لا يستطيع تنبيهك إن توقف السيرفر كله. ضعه على سيرفر آخر صغير، أو أضف لسيرفرك مراقبة خارجية مجانية ثانية.
- Retries 1 أو 2 تمنع الإنذارات الكاذبة من انقطاع لحظي.
- راقب المنافذ المهمة بنوع TCP Port (مثل SSH 2026 أو قاعدة البيانات)، وانتهاء شهادة SSL تلقائيًا.
- ولموارد السيرفر (المعالج والرام) استعمل تنبيهات الموارد في لوحة مرام.
أخطاء شائعة في إعادة تشغيل الخدمات ومراقبتها
تجنّب هذه الأخطاء الشائعة عند إعادة تشغيل الخدمات ومراقبتها:
- restart بدل reload بعد تعديل الإعداد: reload يعيد القراءة دون قطع الاتصالات؛ استعمله متى أمكن.
- إعادة التشغيل دون قراءة السجل: تعالج العَرَض لا السبب فتتكرر المشكلة — اقرأ journalctl أولًا.
- نسيان Restart=on-failure: الخدمة لن تعود وحدها بعد التوقف ما لم تُضِفه.
- مراقبة من داخل السيرفر فقط: إن سقط السيرفر كله لن يصلك تنبيه — راقب من خارجه أيضًا.
- تشغيل حاويات Docker بلا
--restart: لن تعود بعد إعادة تشغيل السيرفر؛ استعمل unless-stopped. - تجاهل امتلاء القرص والذاكرة: من أكثر أسباب توقف الخدمات؛ راقبهما بانتظام.
Uptime Kuma مفتوح المصدر ومجاني بالكامل — راجع مستودعه على GitHub لمزيد من أنواع المراقبة والتنبيهات.
أسئلة شائعة عن إعادة تشغيل الخدمات ومراقبتها
كيف أعيد تشغيل خدمة متوقفة في لينكس؟
استعمل sudo systemctl restart اسم-الخدمة (مثل nginx أو mysql)، ثم تحقّق بـsystemctl status اسم-الخدمة. وبعد تعديل ملف الإعداد فقط استعمل reload بدل restart لتجنّب قطع الاتصالات.
كيف أجعل الخدمة تعود تلقائيًا بعد التوقف؟
أضف Restart=on-failure عبر sudo systemctl edit اسم-الخدمة. ولحاويات Docker شغّلها مع --restart unless-stopped فتعود بعد أي توقف أو إعادة تشغيل للسيرفر.
كيف أعرف لماذا توقفت الخدمة؟
sudo journalctl -u اسم-الخدمة -n 50 يظهر آخر أسطر السجل وسبب التوقف: نفاد ذاكرة (Out of memory)، خطأ إعداد (emerg/syntax error)، منفذ مشغول، أو امتلاء قرص.
ما أفضل أداة مجانية لمراقبة توقف الخدمات؟
Uptime Kuma أداة مفتوحة المصدر ومجانية، تفحص موقعك أو منفذك كل بضع ثوانٍ وترسل تنبيهًا فوريًا إلى تيليجرام عند التوقف والعودة. نصّبناها بـDocker على المنفذ الداخلي 3001.
هل تنبّهني Uptime Kuma إذا توقف السيرفر بالكامل؟
لا إن كانت مثبّتة على السيرفر نفسه؛ فهي تتوقف معه. ضعها على سيرفر آخر صغير، أو أضف مراقبة خارجية مجانية ثانية لتغطية سقوط السيرفر كله.
ما الفرق بين restart وreload؟
restart يوقف الخدمة ثم يشغّلها (يقطع الاتصالات لحظة)، بينما reload يعيد قراءة ملف الإعداد دون قطع — استعمله بعد تعديل إعداد nginx مثلًا.
