النماذج المفتوحة مثل Qwen وLlama صارت خيارًا واقعيًا للشركات العربية التي تريد ذكاءً اصطناعيًا على خوادمها الخاصة. لكن تشغيل Qwen وLlama عربيًا يطرح ثلاثة أسئلة عملية قبل أي شيء: كم ذاكرة تحتاج؟ أي مستوى تكميم (كمّ) تختار؟ ولماذا تستهلك العربية توكنات أكثر من الإنجليزية؟ في هذا الدليل نجيب عن الثلاثة بوضوح — مع قياس فعلي لتجزئة العربية أجريناه على خادم مرام — لتخطّط موارد تشغيل Qwen وLlama عربيًا بدقة بدل التخمين.
محتويات المقال
كم ذاكرة يتطلّب تشغيل Qwen وLlama عربيًا؟
الذاكرة هي القيد الأول. القاعدة التقريبية: الذاكرة اللازمة ≈ عدد المعاملات × بايت لكل معامل (حسب التكميم) + هامش تشغيل + ذاكرة السياق. نموذج بـ 7 مليارات معامل (7B) يحتاج تقريبًا 5 جيجابايت بتكميم Q4، ونحو 15 جيجابايت بدقّة كاملة FP16. هذا الجدول يوجّهك لاختيار الحجم المناسب لخادمك:
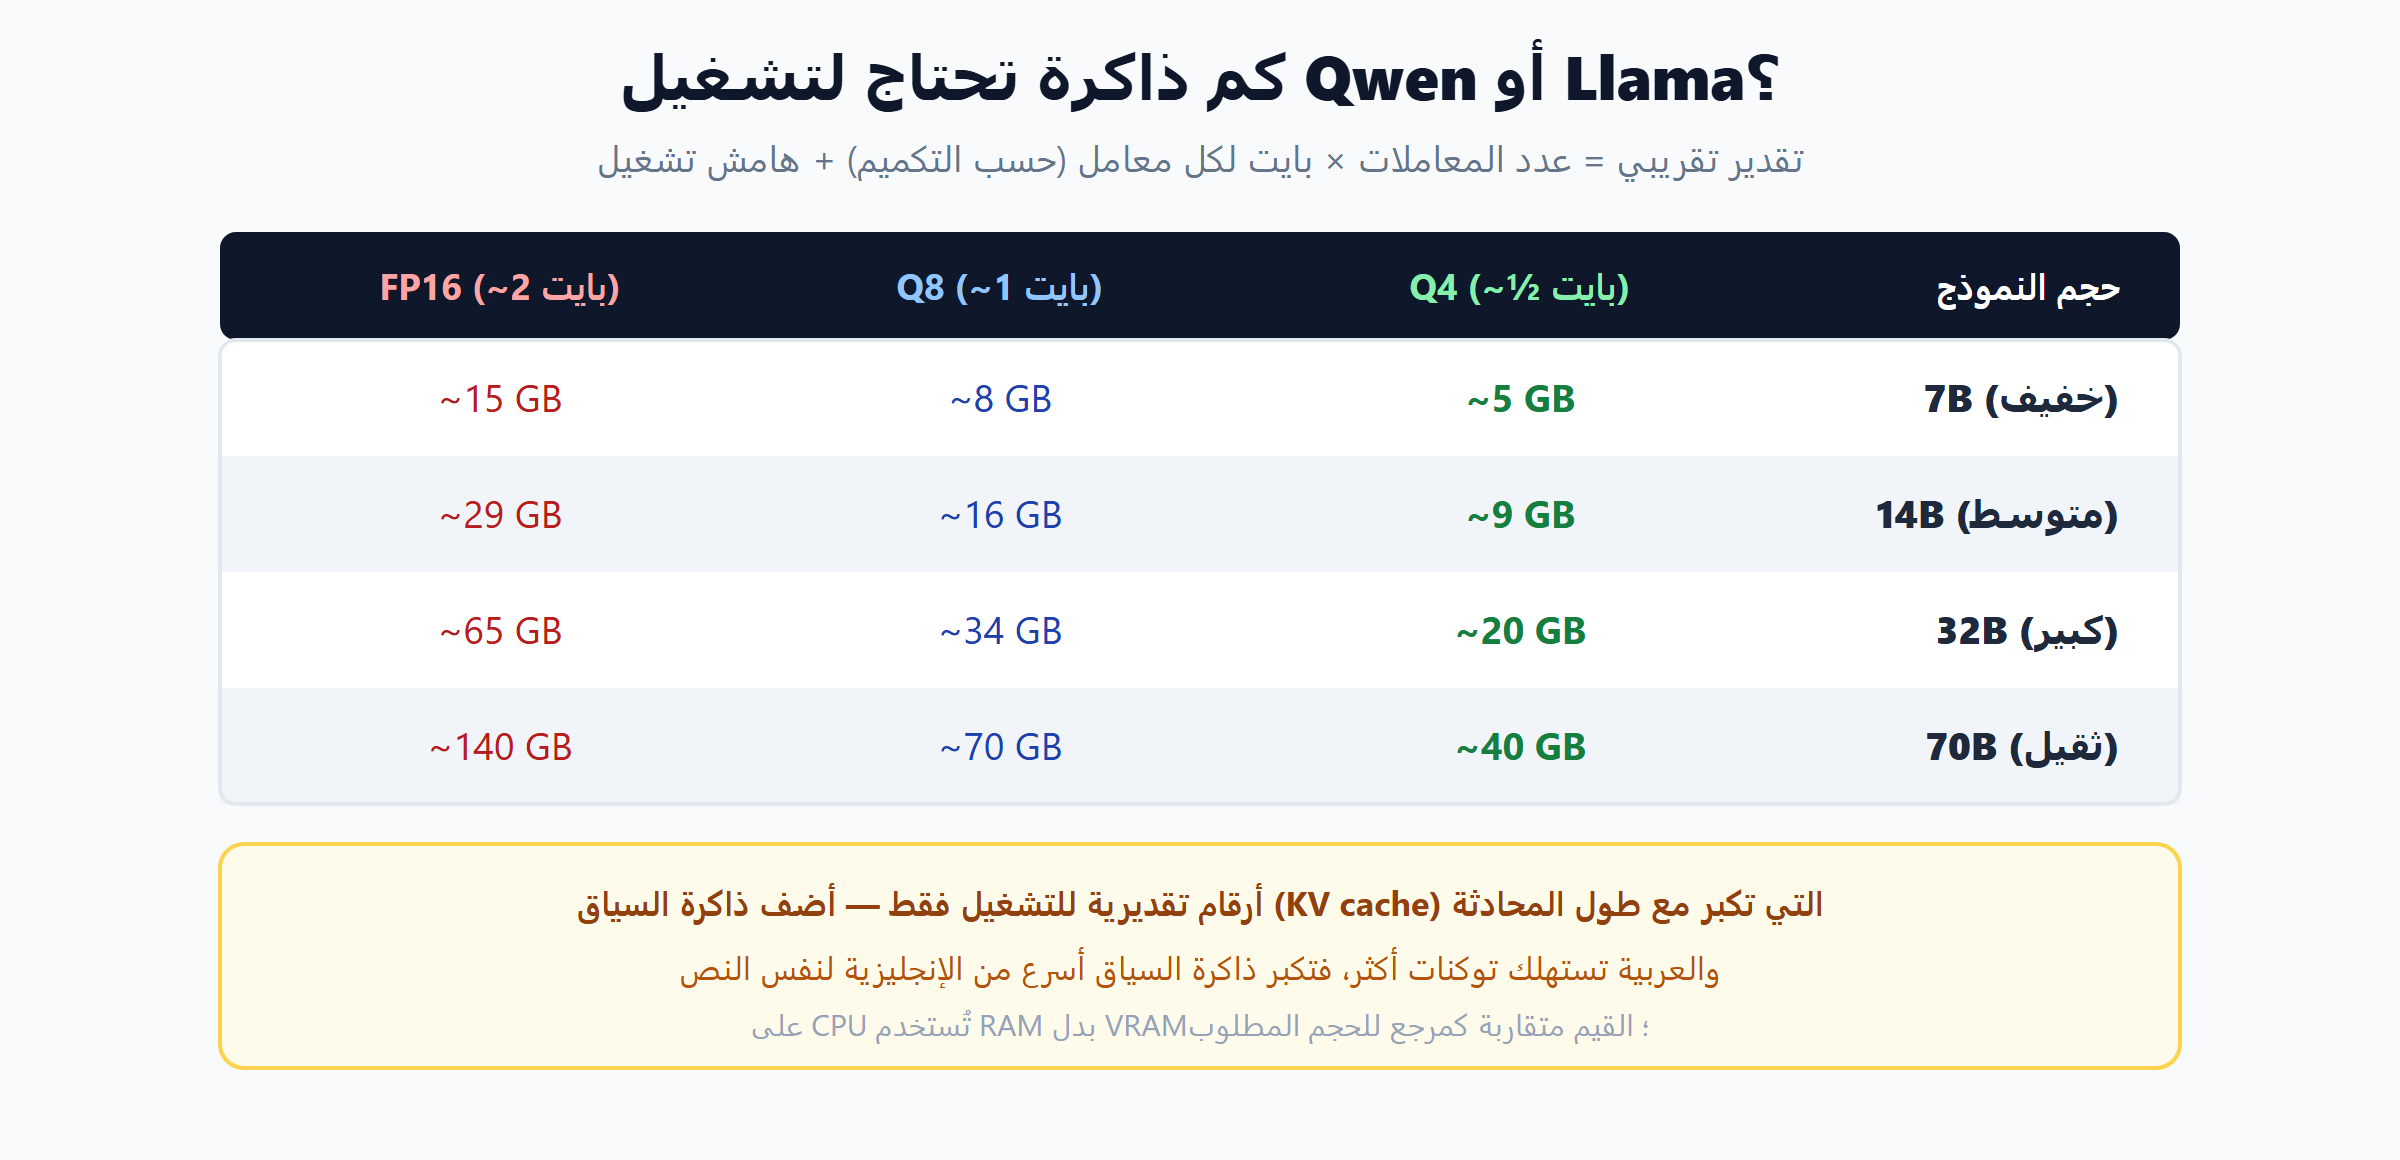
ملاحظة صدق: هذه أرقام تقديرية للتشغيل فقط. أضف إليها ذاكرة السياق (KV cache) التي تكبر مع طول المحادثة — والعربية تستهلك توكنات أكثر، فتكبر ذاكرة سياقها أسرع من الإنجليزية لنفس النص. على المعالج (CPU) تُستخدم RAM بدل VRAM، والقيم متقاربة كمرجع للحجم المطلوب.
الكمّ (Quantization): كيف تقلّص الذاكرة دون خسارة كبيرة؟
التكميم يقلّل دقّة أوزان النموذج (من 16 بت إلى 8 أو 4) فيقلّص الذاكرة كثيرًا وجودته قليلًا. هذا ما يجعل تشغيل نموذج 14B على خادم متواضع ممكنًا:
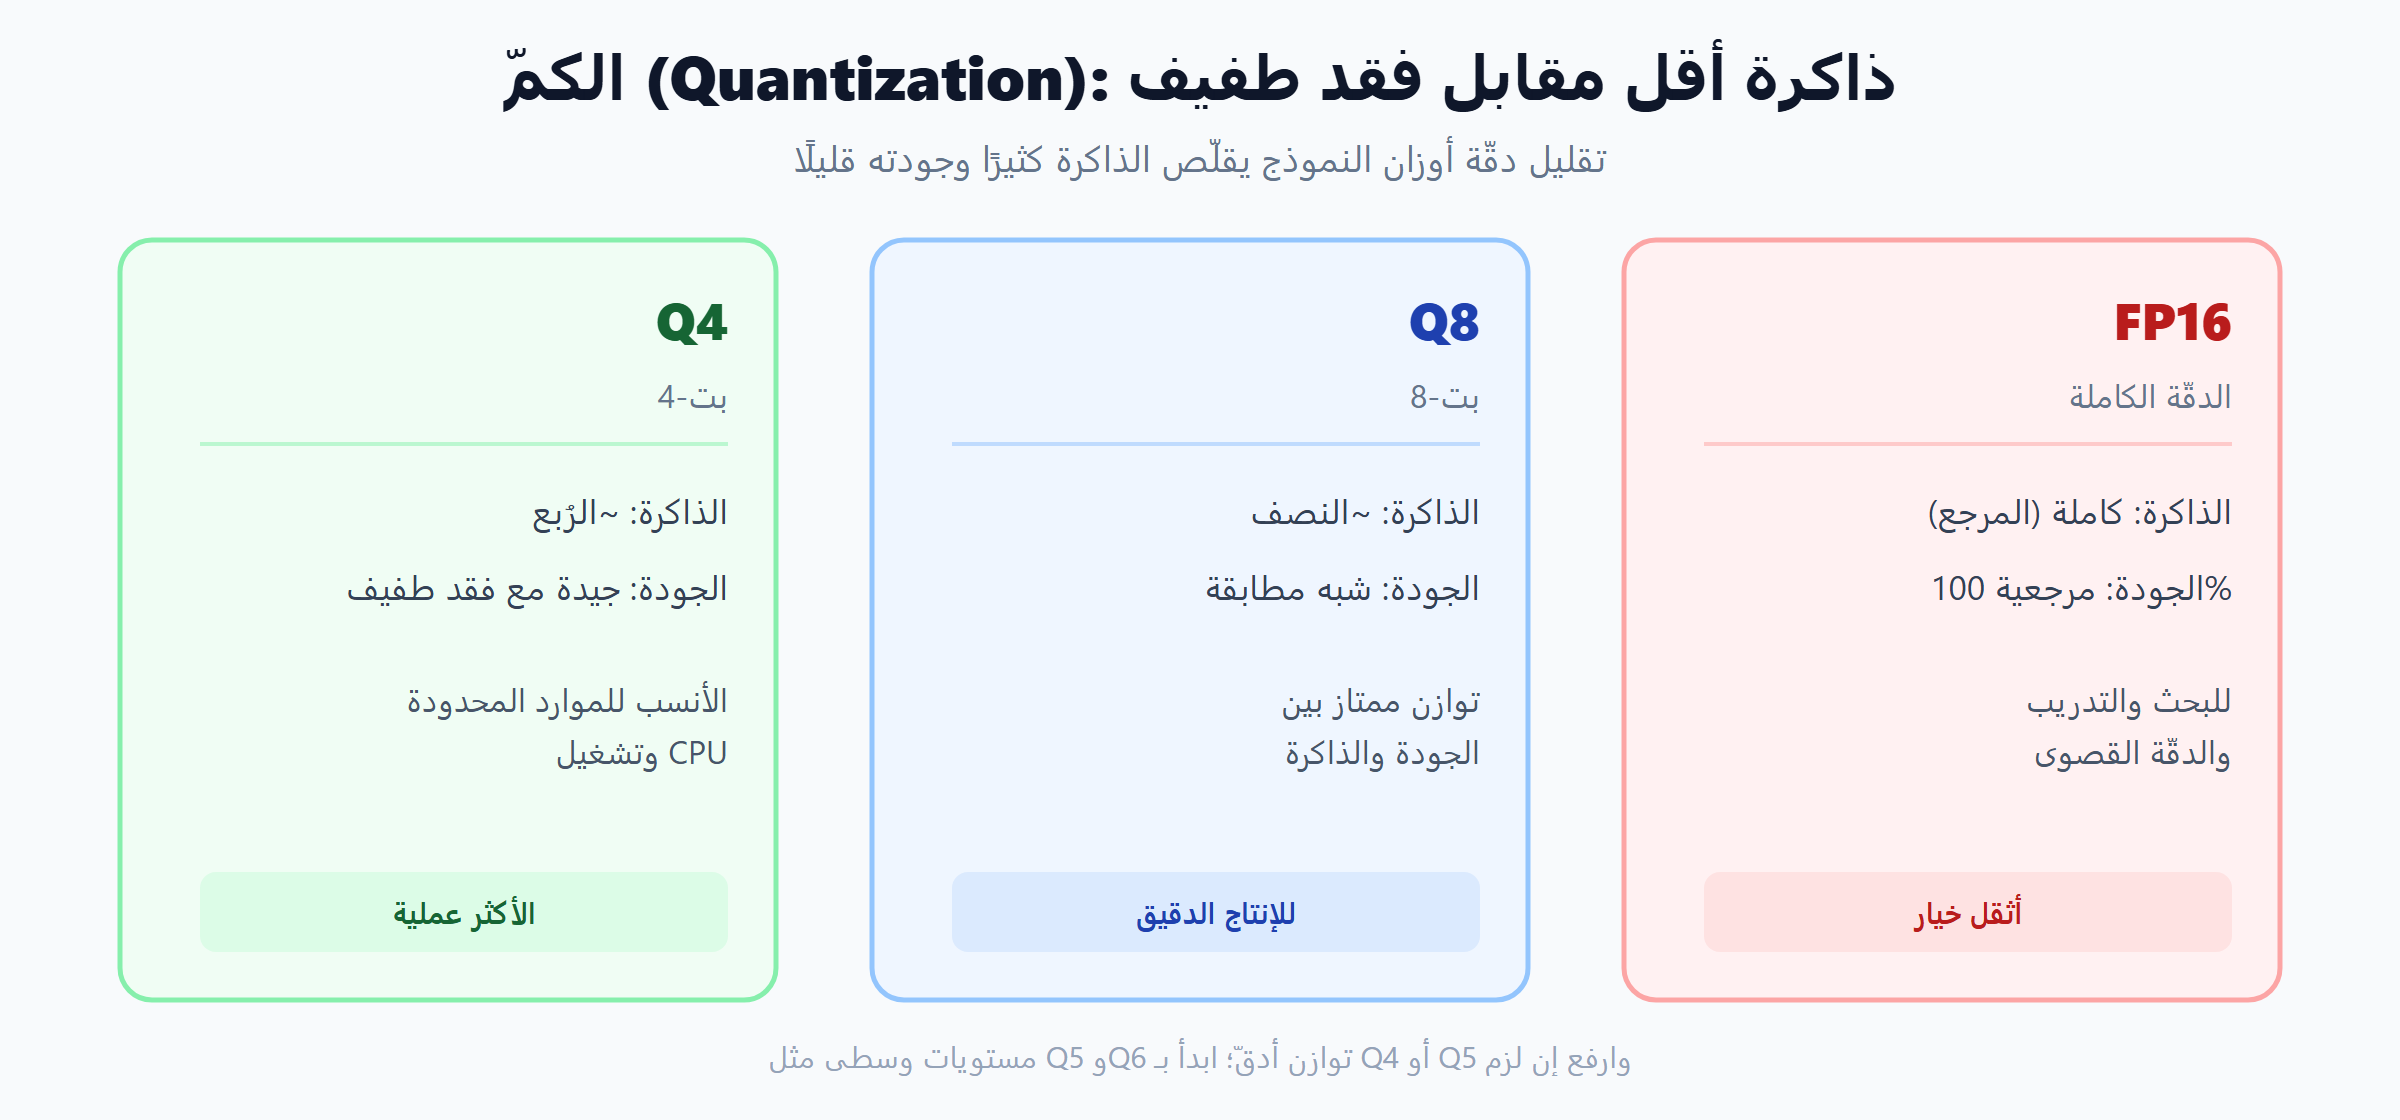
- FP16: الدقّة الكاملة والجودة المرجعية، لكنها الأثقل ذاكرةً — للبحث والدقّة القصوى.
- Q8: نحو نصف الذاكرة بجودة شبه مطابقة — توازن ممتاز للإنتاج الدقيق.
- Q4: نحو ربع الذاكرة بجودة جيدة مع فقد طفيف — الأنسب للموارد المحدودة وتشغيل CPU.
نصيحة عملية: ابدأ بـ Q4 أو Q5 لصيغة GGUF، وارفع إلى Q8 فقط إن لاحظت تراجعًا في جودة المخرجات العربية.
التوكنات: لماذا العربية أغلى من الإنجليزية؟
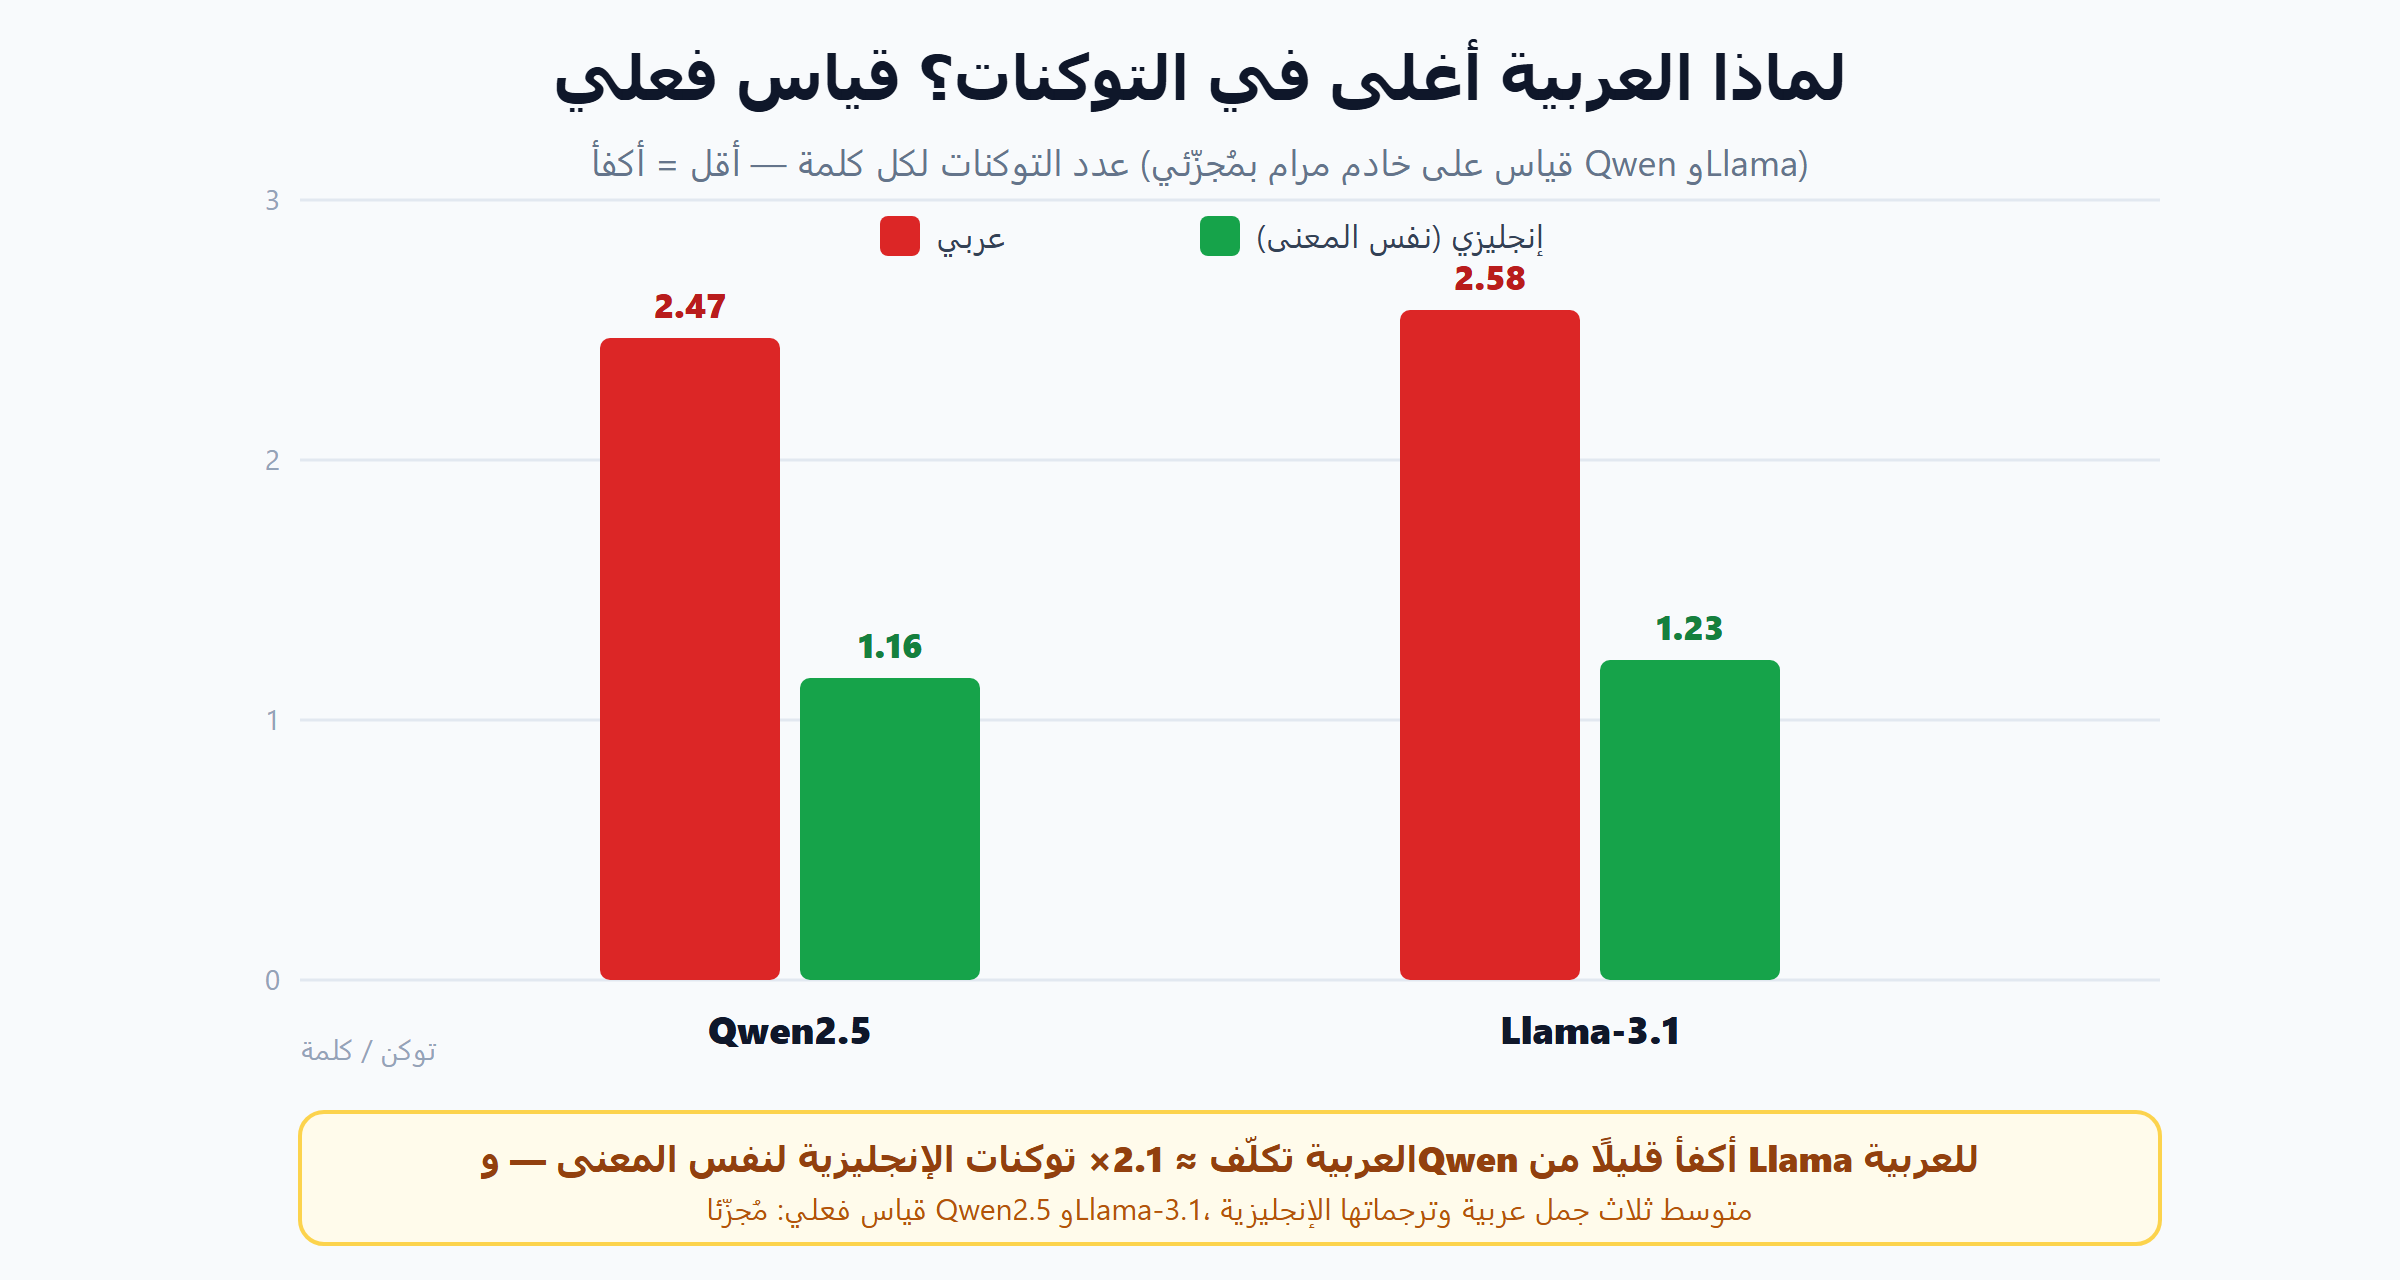
التوكن هو وحدة معالجة النموذج، وكل توكن يكلّف ذاكرة ووقتًا. المشكلة أن العربية تُقسَّم إلى توكنات أكثر من الإنجليزية لنفس المعنى، بسبب طبيعة اللغة وطريقة تدريب المُجزّئات. لقياس ذلك فعليًا، شغّلنا مُجزّئي Qwen2.5 وLlama-3.1 على خادم مرام على ثلاث جمل عربية وترجماتها الإنجليزية، فكانت النتيجة:
- Qwen2.5: العربية 2.47 توكن/كلمة مقابل الإنجليزية 1.16 — أي 2.13×.
- Llama-3.1: العربية 2.58 توكن/كلمة مقابل الإنجليزية 1.23 — أي 2.10×.
الخلاصة المقيسة: تشغيل Qwen وLlama عربيًا يكلّف تقريبًا ضعف توكنات الإنجليزية لنفس المحتوى. لذلك تصل أسرع إلى حدّ السياق، وتستهلك ذاكرة KV cache أكبر، وتدفع أكثر إن كنت تحسب بالتوكن. ولاحظ أن Qwen أكفأ قليلًا من Llama في العربية — فرق صغير لكنه يتراكم مع الحجم.
لماذا يهمّك هذا عمليًا؟ لأن ميزانية السياق والذاكرة والتكلفة كلها تُحسب بالتوكن. إن بنيت مساعدًا عربيًا، خطّط لسياق أطول وذاكرة أكبر مقارنةً بتطبيق إنجليزي مكافئ — أو اختر نموذجًا بمُجزّئ أكفأ للعربية.
Qwen أم Llama للعربية؟
لا يوجد فائز مطلق، لكن لكلٍّ ميوله:
- Qwen: أظهر في قياسنا كفاءة توكنات أفضل قليلًا للعربية، ويُعرف بدعم قوي للغات المتعددة بما فيها العربية — خيار جيد للمحتوى العربي الكثيف.
- Llama: نظام بيئي ضخم وأدوات ومجتمع أوسع وإصدارات كثيرة مكمّمة جاهزة — عملي جدًا للتشغيل السريع والتكاملات.
القرار الأمين: قيّم الجودة على مهمتك العربية تحديدًا بنفسك، فالأرقام العامة لا تُغني عن اختبار مخرجات نموذجك على بياناتك. تجد الإصدارات المكمّمة الجاهزة على Hugging Face، وأداة التشغيل على المعالج llama.cpp. للتنفيذ راجع تشغيل DeepSeek وLLaMA على خادمك وتشغيل Ollama على VPS.
CPU أم GPU لتشغيل Qwen وLlama عربيًا؟
يعتمد الخيار على الحجم والسرعة المطلوبة:
- CPU (عبر llama.cpp وصيغة GGUF المكمّمة): يكفي لنماذج صغيرة/متوسطة مكمّمة (7B–14B بـ Q4) للاستخدام الخفيف أو التجريب، بذاكرة RAM كافية. أبطأ، لكنه أرخص وأبسط.
- GPU: ضروري للنماذج الأكبر (32B–70B) وللسرعة والتزامن العالي؛ ذاكرة الـ VRAM تحدّد أكبر نموذج يمكنك تشغيله. الأنسب للإنتاج الجادّ.
العربية تزيد الحمل (توكنات أكثر = سياق أطول = ذاكرة ووقت أكثر)، فإن كان تطبيقك عربيًا كثيف المحادثة، رجّح كفّة الـ GPU وذاكرة أوفر. وللموازنة بين التشغيل المحلي وواجهات الـ API راجع تكلفة استضافة LLM محليًا مقابل OpenAI API.
نصائح عملية للتشغيل
- اختر حجم النموذج حسب ذاكرتك المتاحة (راجع جدول الذاكرة)، لا حسب الطموح.
- ابدأ بصيغة GGUF مكمّمة (Q4/Q5) لتوفير الذاكرة، وارفع الدقّة إن لزم.
- راقب طول السياق: العربية تستهلك توكنات أسرع، فاضبط حدّ السياق بوعي.
- للمحتوى العربي الكثيف، فضّل نموذجًا بمُجزّئ أكفأ للعربية مثل Qwen.
- إن احتجت معرفة خاصة بشركتك، ادمج النموذج مع RAG بدل نموذج أضخم — راجع RAG للتطبيقات العربية.
- قِس الجودة والسرعة على مهمتك الحقيقية قبل الاعتماد في الإنتاج.
توصيات نماذج عملية للعربية
عند تشغيل Qwen وLlama عربيًا، اختر الحجم حسب مواردك ومهمتك لا حسب الطموح:
- Qwen2.5 يتوفّر بأحجام 7B و14B و32B و72B؛ للعربية الكثيفة يميل كثيرون إليه لكفاءة تجزئته الأفضل قليلًا كما قِسنا.
- Llama 3.1 يتوفّر بـ8B و70B مع نظام بيئي وأدوات أوسع؛ عملي للتشغيل السريع والتكاملات.
- للأجهزة المحدودة: نموذج 7B–8B مكمّم (Q4/Q5) نقطة انطلاق ممتازة.
- للجودة الأعلى بموارد كافية: 14B–32B، أو 70B على GPU بذاكرة كبيرة.
لا يوجد «أفضل» مطلق؛ جرّب حجمين وقارن الجودة والسرعة على مهمتك العربية الحقيقية قبل الاعتماد.
رياضيات ذاكرة السياق (KV cache)
إلى جانب حجم النموذج، تستهلك المحادثة ذاكرة إضافية تُسمّى KV cache تكبر خطيًا مع عدد التوكنات في السياق. تقديريًا تعتمد على عدد الطبقات ورؤوس الانتباه وطول السياق ودقّة التخزين.
المهم عمليًا: كل توكن يضيف ذاكرة، وكلما طال السياق كبرت. وبما أن العربية تكلّف نحو ضعف توكنات الإنجليزية (كما قِسنا فعليًا)، فإن ذاكرة السياق للنص العربي تكبر أسرع لنفس المحتوى. لذلك عند تشغيل Qwen وLlama عربيًا بسياقات طويلة (محادثات أو مستندات)، خصّص ذاكرة أكبر ممّا يوحي به حجم النموذج وحده، أو قلّل حدّ السياق، أو استخدم تكميمًا للـ KV cache إن دعمه محرّك التشغيل.
أدوات التشغيل: Ollama وllama.cpp وvLLM
يعتمد اختيار المحرّك على هدفك:
- Ollama: الأسهل للبدء، يشغّل نماذج GGUF على CPU أو GPU بأوامر بسيطة — مثالي للتجربة والاستخدام الفردي.
- llama.cpp: محرّك مُحسّن لتشغيل GGUF على CPU (وGPU جزئيًا)، بتحكّم دقيق بالموارد والتكميم.
- vLLM: للـ GPU والإنتاج عالي التزامن؛ إنتاجية عالية عبر إدارة ذكية لذاكرة السياق (PagedAttention).
للتجربة والاستخدام الخفيف ابدأ بـ Ollama؛ وللإنتاج على GPU بتزامن عالٍ اتجه إلى vLLM.
خطوات البدء العملية
- قدّر ذاكرتك المتاحة واختر حجم نموذج ومستوى تكميم يناسبانها.
- نزّل نسخة GGUF مكمّمة (Q4/Q5) من مصدر موثوق مثل Hugging Face.
- شغّلها عبر Ollama أو llama.cpp وجرّب مطالبات عربية حقيقية من مجالك.
- راقب استهلاك الذاكرة وطول السياق، خصوصًا مع النصوص العربية الطويلة.
- قِس الجودة والسرعة على مهمتك، وارفع الحجم أو الدقّة تدريجيًا إن لزم.
بهذه الخطوات يصبح تشغيل Qwen وLlama عربيًا عمليًا وقابلًا للتوسّع دون هدر موارد.
من واقع مرام
من واقع مرام: قِسنا فعليًا على خادم مرام أن العربية تكلّف نحو ضعف توكنات الإنجليزية (Qwen 2.13×، Llama 2.10×)، وأن Qwen أكفأ قليلًا للعربية. عمليًا هذا يعني: خطّط لذاكرة وسياق أكبر عند تشغيل Qwen وLlama عربيًا مقارنةً بتطبيق إنجليزي. ابدأ بنموذج مكمّم يناسب ذاكرتك، ووسّع إلى GPU حين ترتفع الأحجام والتزامن. نوفّر خوادم بموارد وذاكرة كافية وخيارات GPU لتشغيل النماذج المفتوحة عمليًا.
أخطاء شائعة عند تشغيل Qwen وLlama عربيًا
بعد فهم الذاكرة والتكميم والتوكنات، تبقى أخطاء متكررة تُهدر الموارد. تجنّبها يجعل تشغيل Qwen وLlama عربيًا أكثر كفاءة واقتصادًا:
- اختيار نموذج أكبر من ذاكرتك: ثم معاناة البطء الشديد أو الانهيار. طابق حجم النموذج ومستوى التكميم مع ذاكرتك المتاحة أولًا.
- تجاهل زيادة توكنات العربية في حدّ السياق: العربية تكلّف نحو ضعف الإنجليزية، فخصّص سياقًا أطول وذاكرة أكبر للتطبيقات العربية.
- استخدام دقّة FP16 دون حاجة: على موارد محدودة، التكميم (Q4/Q5) يوفّر ذاكرة كثيرة بفقد جودة طفيف — ابدأ به وارفع إن لزم.
- الحكم على النموذج بأرقام عامة: قيّم الجودة على مهمتك العربية تحديدًا، لا على معايير إنجليزية أو ترتيبات عامة.
- القفز إلى GPU مبكرًا: النماذج الصغيرة المكمّمة تعمل على CPU للاستخدام الخفيف؛ لا تدفع ثمن GPU قبل أن تحتاجه فعلًا.
باختصار، نجاح تشغيل Qwen وLlama عربيًا يبدأ من مطابقة الموارد مع النموذج، ووعي كلفة توكنات العربية، واختيار مستوى التكميم المناسب — لا من مجرد تحميل أكبر نموذج متاح.
الأسئلة الشائعة
كم ذاكرة أحتاج لتشغيل نموذج 7B؟
تقديريًا نحو 5 جيجابايت بتكميم Q4، ونحو 8 جيجابايت بـ Q8، ونحو 15 جيجابايت بدقّة FP16 — زائد ذاكرة السياق التي تكبر مع طول المحادثة.
هل العربية فعلًا أغلى في التوكنات؟
نعم. في قياسنا الفعلي على خادم مرام، كلّفت العربية نحو 2.1× توكنات الإنجليزية لنفس المعنى (Qwen 2.47 مقابل 1.16 توكن/كلمة، وLlama 2.58 مقابل 1.23).
Qwen أم Llama أفضل للعربية؟
أظهر Qwen كفاءة توكنات أفضل قليلًا للعربية في قياسنا، بينما يتميّز Llama بنظام بيئي أوسع. الأفضل تقييم الجودة على مهمتك العربية بنفسك.
ما فائدة التكميم (Quantization)؟
يقلّل دقّة أوزان النموذج فيخفّض الذاكرة كثيرًا (Q4 نحو ربع FP16) بفقد جودة طفيف — ما يتيح تشغيل نماذج أكبر على موارد أقل.
هل أشغّلها على CPU أم أحتاج GPU؟
النماذج الصغيرة/المتوسطة المكمّمة تعمل على CPU للاستخدام الخفيف. النماذج الأكبر والسرعة والتزامن العالي تحتاج GPU، خاصة مع الحمل الإضافي للعربية.
الخلاصة
تشغيل Qwen وLlama عربيًا قرار موارد قبل أن يكون قرار نموذج: قدّر الذاكرة حسب الحجم والتكميم، واعرف أن العربية تكلّف نحو ضعف توكنات الإنجليزية فخطّط لسياق وذاكرة أكبر، واختر بين CPU وGPU حسب الحجم والسرعة. بهذه الأرقام — بعضها مقيس فعليًا — تخطّط بدقّة بدل التخمين، وتبني ذكاءً عربيًا على بنيتك الخاصة بثقة.
