
كل فريق يبني ميزة ذكاء اصطناعي يواجه السؤال نفسه: هل ندفع لكل استدعاء عبر OpenAI API، أم نشغّل نموذجًا مفتوحًا على خادم GPU خاص بنا؟ الجواب في جوهره سؤال تكلفة. تكلفة استضافة LLM محليًا تكلفة ثابتة شهريًا مهما زاد استخدامك، بينما تكلفة الـ API تكلفة متغيّرة ترتفع مع كل توكن. في هذا الدليل نحسب تكلفة استضافة LLM مقابل OpenAI API بأسعار حقيقية معلنة، ونحدّد «نقطة التعادل» التي يصبح بعدها الخادم المحلي أوفر — ونعطيك طريقة تحسب بها نقطتك أنت.
محتويات المقال

كيف تُحسب تكلفة استضافة LLM محليًا؟
حين تستضيف نموذجًا مفتوحًا (مثل Llama أو DeepSeek أو Qwen) على خادم GPU مُدار، تصبح تكلفة استضافة LLM بندًا واحدًا واضحًا: الإيجار الشهري للخادم. هذا الإيجار يشمل بطاقة الـ GPU والكهرباء والتبريد والشبكة — كلها ضمن السعر، فلا تشتري عتادًا ولا تدير مركز بيانات. والأهم أنها تكلفة ثابتة: سواء عالجت مليون توكن أو مئة مليون، الفاتورة نفسها ما دمت ضمن طاقة الخادم.
على سبيل المثال، تبدأ خطط GPU من فئة NVIDIA L4 لدى مرام من نحو 180 دولارًا شهريًا، وترتفع فئة RTX A6000 (48GB) إلى مئات الدولارات لمن يحتاج نماذج أكبر أو تزامنًا أعلى. الرقم الدقيق يعتمد على البطاقة والموارد — راجع صفحة خوادم GPU للأسعار المحدّثة. سنستخدم خطة الـ 180 دولارًا كمرساة في الحسابات التالية.
كيف تُحسب تكلفة OpenAI API؟
على الجهة المقابلة، OpenAI API لا يفرض أي تكلفة ثابتة — تدفع فقط مقابل ما تستهلكه، ويُحسب بالتوكنات (أجزاء الكلمات) إدخالًا وإخراجًا. الأسعار تتفاوت كثيرًا حسب النموذج: نموذج صغير مثل GPT-4o mini أرخص بكثير من نموذج كبير مثل GPT-4o. هذه مرونة رائعة للبدايات والاستخدام المتقطّع، لكنها تتحوّل إلى فاتورة متصاعدة مع نمو الحجم.
تنبيه أسعار: أسعار الـ API تتغيّر باستمرار، والأرقام هنا أمثلة معلنة وقت الكتابة لأغراض التوضيح. تحقّق دائمًا من صفحة أسعار OpenAI الرسمية قبل أي قرار.
نقطة التعادل: متى يتساوى الخياران؟
نقطة التعادل هي حجم الاستخدام الذي تتساوى عنده الفاتورتان. حسابها بسيط:
المعادلة: نقطة التعادل (بملايين التوكنات) = التكلفة الشهرية الثابتة ÷ سعر المليون توكن. مثال: خطة بـ 180$ ÷ سعر 10$ للمليون = 18 مليون توكن شهريًا. تحت هذا الحجم الـ API أوفر، وفوقه باستمرار الخادم المحلي أوفر.
لاحظ أن النقطة تتحرّك حسب فئة النموذج الذي تستبدله: كلما كان نموذج الـ API الذي تعتمد عليه أغلى (أي أعلى جودة)، أسرع تُسدّد خطة الاستضافة المحلية نفسها.
أمثلة واقعية بأرقام معلنة
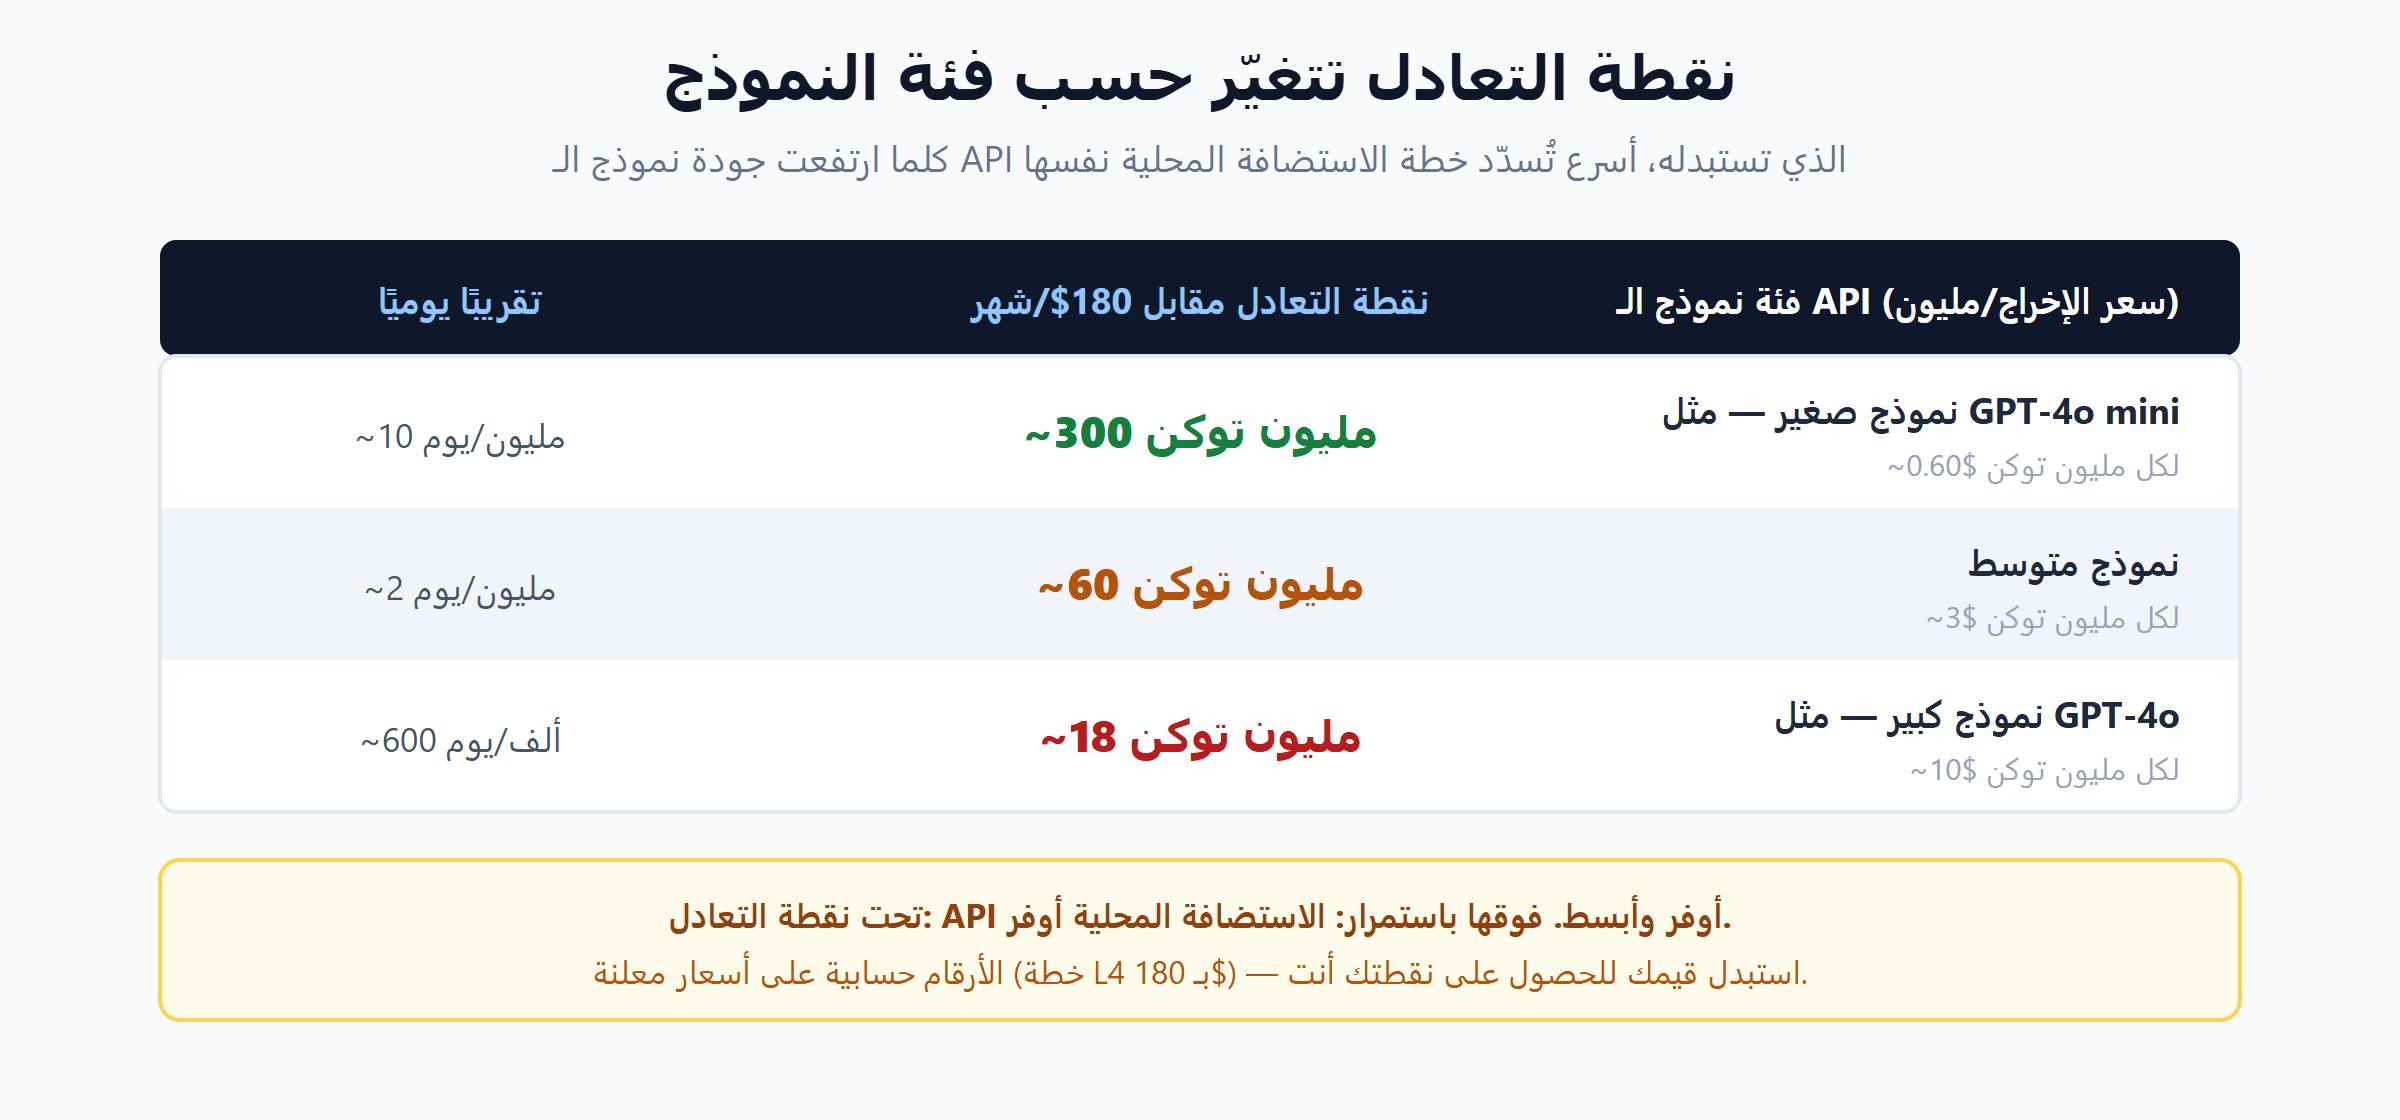
إذا كنت تستبدل نموذجًا صغيرًا رخيصًا، فلن يتساوى الخياران إلا عند حجم ضخم (~300 مليون توكن شهريًا) — أي أن الـ API يبقى أوفر لمعظم الفرق الصغيرة. أما إن كنت تحتاج جودة نموذج كبير مثل GPT-4o، فنقطة التعادل تنخفض إلى ~18 مليون توكن شهريًا فقط (نحو 600 ألف توكن يوميًا) — وهو حجم يبلغه بسهولة أي منتج فيه محادثة أو تلخيص مكثّف. هنا تتحوّل تكلفة استضافة LLM الثابتة إلى توفير حقيقي.
ما وراء السعر: عوامل غير التكلفة
التكلفة مهمة، لكنها ليست العامل الوحيد. قبل أن تقرر، وازن هذه الفروق الجوهرية:

- الخصوصية وسيادة البيانات: مع الاستضافة المحلية تبقى بيانات عملائك على خادمك — ميزة مهمة للسوق العراقي والعربي والقطاعات الحسّاسة.
- زمن الاستجابة وحدود المعدّل: خادمك الخاص بلا rate limits خارجية، وقريب جغرافيًا من مستخدميك.
- جودة النموذج: النماذج المفتوحة تطوّرت كثيرًا وتنافس النماذج المغلقة في مهام عديدة، لكنها ليست متطابقة دائمًا — قيّم الجودة على مهمتك بنفسك قبل الاعتماد.
- العمليات والصيانة: الاستضافة المحلية تتطلب إعدادًا وتحديثًا ومراقبة؛ الـ API يعفيك من ذلك تمامًا.
كيف تختار: تكلفة استضافة LLM أم API لمشروعك؟
لاتخاذ قرار مبني على أرقامك أنت لا على قاعدة عامة، اتبع هذه الخطوات:
- قدّر حجم استخدامك الشهري بالتوكنات (إدخال + إخراج) في ذروة واقعية.
- حدّد فئة النموذج التي تحتاجها فعلًا (صغير كافٍ أم تحتاج جودة كبيرة؟).
- احسب فاتورة الـ API المتوقّعة = الحجم × سعر المليون للنموذج المختار.
- قارنها بخطة GPU ثابتة تكفي نموذجك (مثلًا L4 من ~180$ للنماذج المتوسطة).
- ازن العوامل غير التكلفة: خصوصية، زمن استجابة، وقدرة فريقك على التشغيل.
- إن كنت قرب نقطة التعادل، فكّر في نهج هجين: نموذج مفتوح محلي للحجم الثقيل، وAPI للمهام النادرة المعقّدة.
للتنفيذ العملي، راجع دليل كيف تستضيف AI API على خادم GPU ودليل تشغيل DeepSeek وLLaMA على خادمك. ولمزيد عن النماذج المفتوحة راجع مكتبة Hugging Face.
من واقع مرام
من واقع مرام: معظم الفرق العراقية الصغيرة تبدأ بالـ API لأنه أبسط وأرخص عند الحجم المنخفض. لكن ما إن يستقرّ المنتج ويرتفع الاستخدام حتى تصبح خطة GPU ثابتة (تبدأ من فئة L4) أوفر وأكثر خصوصية وقابلية للتنبّؤ. الأرقام تعتمد على حجمك ونموذجك — والحساب على بياناتك أنت هو الفيصل، ونحن نساعدك في اختيار الخطة الأنسب.
الأسئلة الشائعة
ما نقطة التعادل بين الاستضافة المحلية وOpenAI API؟
هي حجم الاستخدام الشهري الذي تتساوى عنده الفاتورتان، ويُحسب بقسمة التكلفة الشهرية الثابتة على سعر المليون توكن. مثال: خطة 180$ ÷ 10$ للمليون = 18 مليون توكن شهريًا.
هل الاستضافة المحلية أرخص دائمًا؟
لا. عند الحجم المنخفض أو المتقطّع يبقى الـ API أوفر لأنه بلا تكلفة ثابتة. الاستضافة المحلية تتفوّق فوق نقطة التعادل عند الاستخدام الكبير المستمر.
هل النماذج المفتوحة بجودة GPT-4o؟
تطوّرت النماذج المفتوحة كثيرًا وتنافس في مهام عديدة، لكنها ليست متطابقة دائمًا مع النماذج المغلقة. قيّم الجودة على مهمتك تحديدًا قبل الاعتماد الكامل.
ماذا تشمل تكلفة استضافة LLM على خادم مُدار؟
تشمل بطاقة الـ GPU والكهرباء والتبريد والشبكة ضمن الإيجار الشهري الثابت، دون شراء عتاد أو إدارة مركز بيانات. تدفع فقط اشتراك الخادم.
هل يمكن الجمع بين الاثنين؟
نعم، وهو نهج شائع: نموذج مفتوح محلي يخدم الحجم الثقيل بتكلفة ثابتة، مع استدعاء API لنموذج كبير في المهام النادرة المعقّدة — فتحصل على أفضل الكلفتين.
الخلاصة
الفرق بين الخيارين ليس «أيّهما أرخص» بل «عند أي حجم». تكلفة استضافة LLM محليًا ثابتة تكافئ الحجم الكبير المستمر وتمنحك خصوصية وتحكّمًا، بينما OpenAI API أوفر وأبسط عند الحجم المنخفض. احسب نقطة التعادل بأرقامك، وازن العوامل غير التكلفة، ولا تتردّد في المزج بين الاثنين. في مرام نوفّر خوادم GPU مُدارة قريبة من سوقك تجعل الاستضافة المحلية خيارًا عمليًا واقتصاديًا.
